
こんにちは。三村(@t_mimura39)です。
皆さんは、長年運用されてきたモノリシックなRailsアプリケーションから「認証」のような根幹機能を切り出した経験はありますか?
言葉にすると一行ですが、実際にやろうとすると胃が痛くなるテーマですよね。
今回はメドピアで2025年4月に走り出した「共通基盤プロジェクト」について、その背景と設計の裏側をご紹介します。
※ 本記事は共通基盤プロジェクトの立ち上げ(2025年4月)以降、執筆時点(2026年6月)までの取り組みをまとめたものです。プロジェクトは現在も進行中のため、今後さらに形が変わっていく可能性がある点はご留意ください。
目次
- 🙋 はじめに 🙋
- 🏚️ 背景 — 10年もののモノリスとClinPeerの狭間で 🏚️
- 🏗️ 共通基盤プロジェクトとは 🏗️
- 👥 ユーザー情報連携 👥
- 🔐 認証連携 🔐
- 📍 現在地 — すべての医師向けサービスがつながった 📍
- 👋 まとめ 👋
🙋 はじめに 🙋
本記事では、メドピアが抱えていた共通機構(特に「ユーザー管理」と「認証」)を切り出して再構築する 共通基盤プロジェクト の全体像と、設計上工夫したポイントについて記述します。
個別の実装コードの詳細までは踏み込まず、「なぜそういう判断をしたのか」という意思決定の部分を中心にお伝えできればと思います。「社内サービスの認証基盤を再構築したい」という似た境遇の方に、何かしらの参考になれば幸いです。
🏚️ 背景 — 10年もののモノリスとClinPeerの狭間で 🏚️
弊社の医師集合知プラットフォーム「MedPeer」(medpeer.jp)は、元々PHPで実装されていたシステムを2016年頃からRubyに移植し始めました。
今現在は(社内専用の一部の管理画面を除いて)すべてRubyへの移植が完了しています。
……が、Ruby移植が始まってからもう 10年近く 経過しています。しかもDBは前システムのDB(なんなら前の前のシステムのDBもあったり)を参照している、なかなかに歴史のあるモノリシックなアプリケーションです。
こうなると、機能拡張、特に認証などの基盤となる部分の変更は慎重にならざるを得ません。触るたびに「ここを変えて大丈夫だろうか」と冷や汗をかく、そんな状況です。
そんな中、2024〜2025年にかけてメドピアでは新サービス「ClinPeer」を立ち上げました。ClinPeerの詳細な紹介は割愛しますが(興味がある方は ClinPeer 紹介ページ をご覧ください)、要件の一つに「MedPeerと同一のアカウントでログインできること」がありました。
MedPeerには他サービスへ認証状態を連携する仕組みが備わっているため、その仕組みに乗っかるだけでSSO的な挙動は実現できました。が、1点だけ厄介なことがありました。
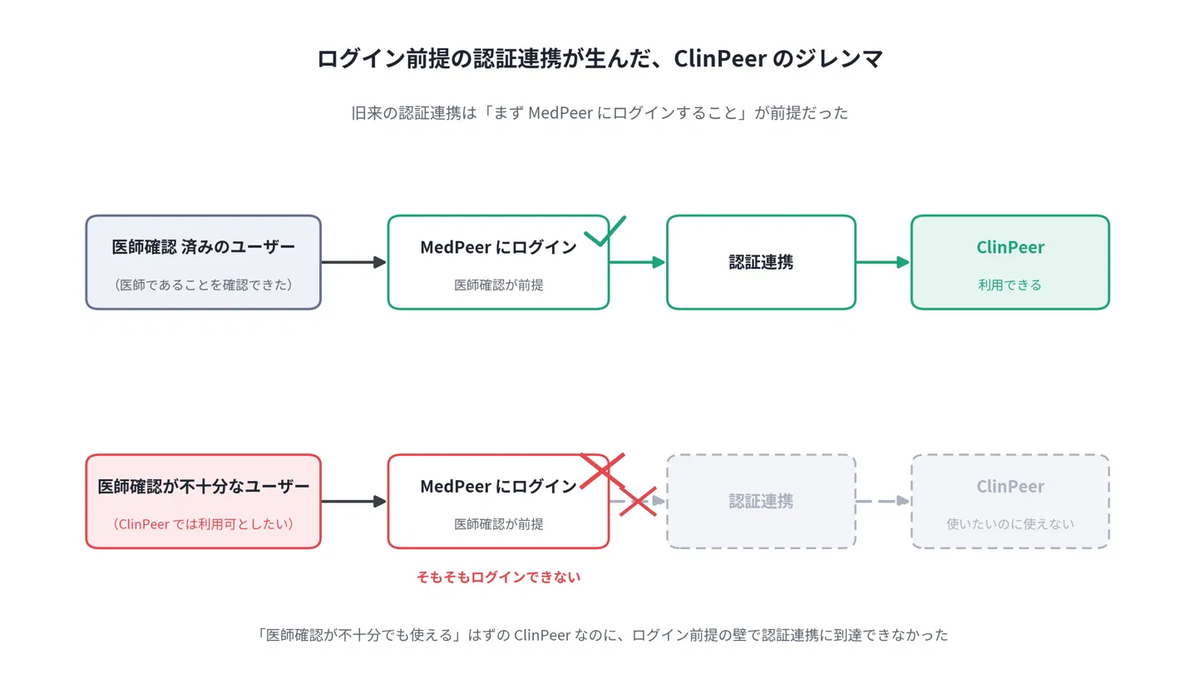
MedPeerは医師向けサービスで、「医師であることが確認できたユーザー」のみが利用できるよう制限されています。一方のClinPeerも医師向けサービスではあるのですが、「医師であることの確認が十分でなくとも利用は可能とする」という要件でした。
一見すると些細な仕様差異に見えますよね。私も最初はそう思っていました。ところがこれがなかなかに厄介だったのです。
MedPeerの認証連携は「まずMedPeerにログインすること」を前提としているため、「医師であることの確認が十分でないユーザー」はそもそもMedPeerにログインできず、認証連携の処理を実行できなかったのです。
これは負債だと認識しつつも、ClinPeerの開発が急務だったため、苦肉の策として if clinpeer? のような判定処理をMedPeerのリポジトリにいくつか埋め込み、パズルのように本問題を凌ぎました。
しかし、誰かがいずれこの負債には向き合わなくてはいけません。
そんなこんなで、MedPeerから「認証」などの共通処理を切り出し、再構築するプロジェクトが2025年4月に走り出しました。その名も「共通基盤プロジェクト」です。(そのまま)
🏗️ 共通基盤プロジェクトとは 🏗️
共通基盤プロジェクトは、MedPeerが中心となって抱え込んでいた共通機構を外に切り出し、MedPeer自身もClinPeerなどと同列の位置付けにする ことを目的としています。
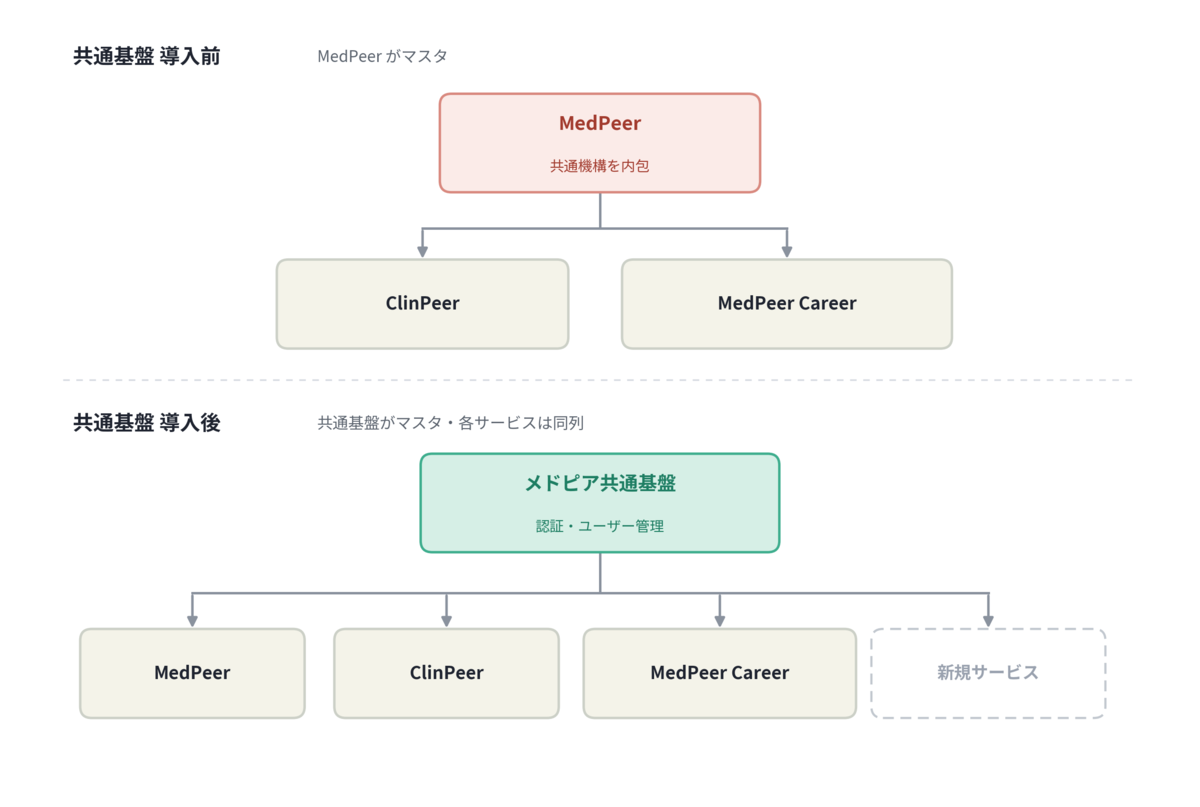
切り出す対象として想定しているのは、以下のようなものです。
- ユーザー管理
- 認証
- お問い合わせ
- ポイント
などなど。
その中でも、まずは「ユーザー管理」、そして「認証」から共通基盤に切り出していきます。本記事でもこの2つを順に見ていきましょう。
👥 ユーザー情報連携 👥
現状、MedPeer・ClinPeer・MedPeer Careerはそれぞれが独立したRailsシステムであり、それぞれのDBにユーザー情報が格納されています。位置付けとしては MedPeerのユーザー情報がマスタ で、他サービスにはそれが転記されている、という形でした。
これを、共通基盤をマスタ とする形に置き換えていきます。
共通基盤DBにユーザー情報を格納する
まずは共通基盤DBに、MedPeer相当のユーザー情報を同期します。
システム間連携の仕組みとして、当初はApache Kafkaなども検討しました。が、最終的には お手軽で、かつ柔軟に対応しやすい ように、専用の同期APIを共通基盤側に実装し、MedPeerでユーザー情報が更新されるたびにその同期APIを呼び出す、という素朴な作りにしました。きらびやかな仕組みより、まず確実に動いて運用しやすいものを選んだ形です。
そして今回、特に大事にしていたのが「過去の負債を引き継がない」という点です。
前述の通り、MedPeerには10年では効かないような前々世代のDBが現役で動いています。こういったテーブルはRailsと相性が悪いものが多く、また「MedPeerに特化した設計」になっています。
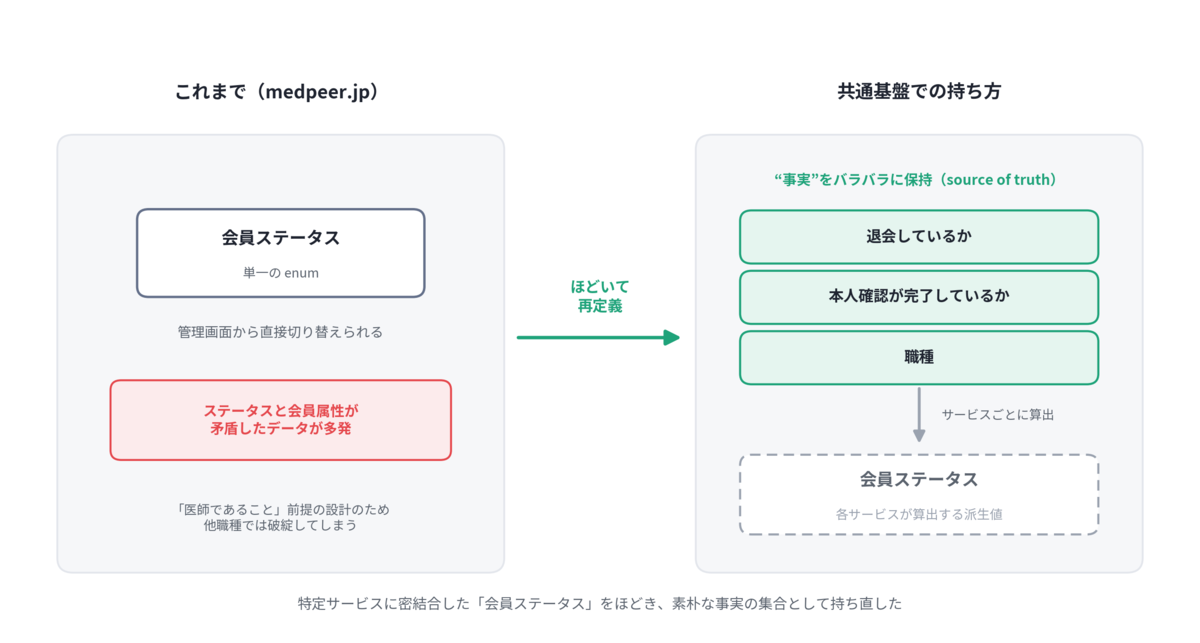
たとえばMedPeerでは「会員ステータス(サービス利用可能、一部サービス利用可能、退会 など)」を管理していましたが、これは「医師であること」を前提に設計されていました。そのため、薬剤師のような医師以外の職種でもサービスを利用できるようにすると、会員ステータスという概念そのものが破綻してしまう状況だったのです。
そこで共通基盤では 会員ステータスという概念をあえて持たない ことにしました。代わりに、
- 退会しているかどうか
- 本人確認が完了しているか否か
- 職種
といった情報を バラバラに保持 し、それらを連携先の各サービスが必要に応じて判定する形としました。
そして、この「バラして持ち直す」という整理、見た目以上に骨が折れました。
元の会員ステータスはenum的に管理されており、しかも管理画面からそのenumをコロコロと切り替えられる機能まで備わっていました。 お察しの良い方はもうお気づきかもしれませんね。蓋を開けてみると、ステータスと会員属性の関係性に矛盾が生じているユーザーデータがたくさん 存在していたのです。
「ユーザー属性的にはMedPeerの全ての機能が利用できて良いのだが、諸事情により機能を制限している」など
そこで一つひとつ事情を紐解き、必要に応じて仕様を変更したり、ユーザー属性を新設するなどをした後に最終的には「いくつかのユーザー属性から算出できるもの => 会員ステータス」という位置付けに整理し直すことができました。
「会員ステータス」という一見便利だが特定サービスに密結合した概念を一度ほどき、より素朴な事実の集合として持ち直す。地味ですが、ここを妥協しなかったことが後々効いてくると考えています。
共通基盤の情報を各サービスへ展開する
無事に共通基盤DBがMedPeer相当のユーザー情報を持つようになったら、次は他サービスへの同期の切り替えです。
これまで「MedPeer → ClinPeer」だったデータの流れを、まずは「MedPeer → 共通基盤 → ClinPeer」のように共通基盤が仲介する形へと、徐々に切り替えていきます。
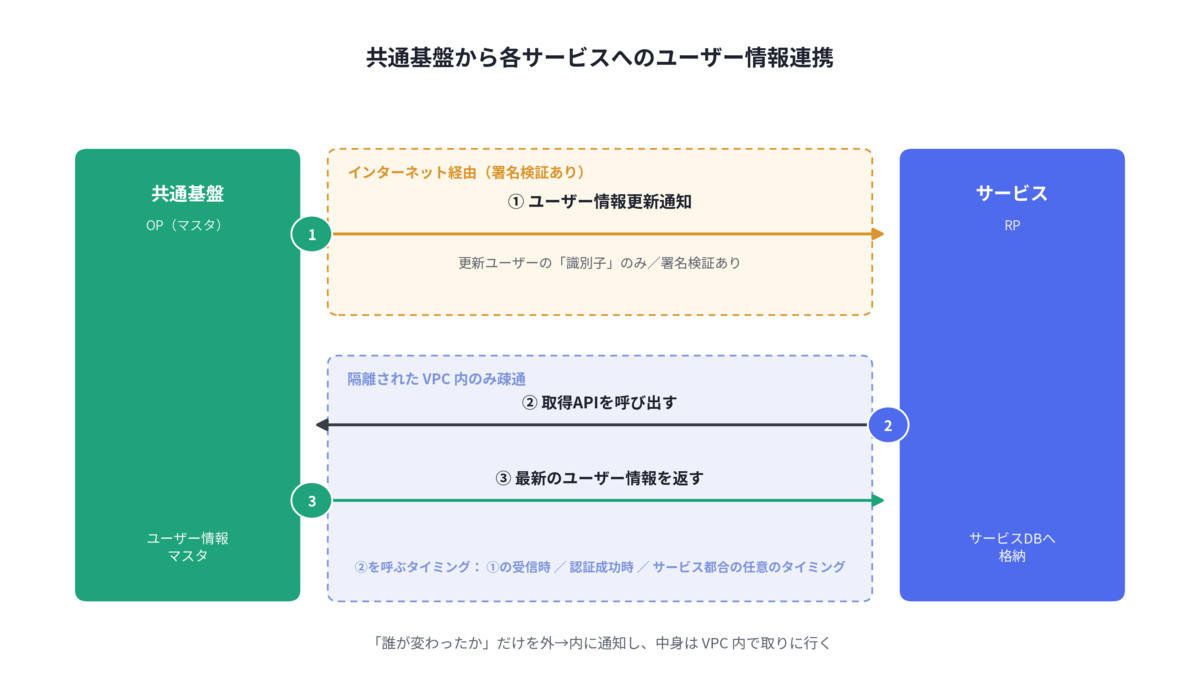
共通基盤から他サービスへのユーザー同期は、シンプルに次の2つの仕組みで成り立っています。
- ユーザー情報更新通知
- インターネット経由で送信し、署名検証の仕組みあり。通知ペイロードには「更新が発生したユーザーの識別子」のみが含まれます。
- 共通基盤でユーザー情報が更新されたタイミングで、共通基盤 → 各サービスの向きに通信されます。
- ユーザー情報取得API
- 隔離されたVPC内でのみ疎通可能。
- 上記の更新通知の受信時や、後述する認証成功時、あるいはサービス都合の任意のタイミングで本APIを呼び出し、最新のユーザー情報をサービスDBに格納します。
通知では「誰が更新されたか」だけを伝え、実際の中身は各サービスがVPC内のAPIで取りに来る。センシティブな情報をインターネット経由で流さずに済むため、この役割分担はなかなか上手くハマったと感じています。
💡 ちょこっと工夫: heartbeatで「通知の消失」を防ぐ 💡
ここで一つ、設計上の工夫を紹介させてください。
今回は とにかく各サービスの開発負担を小さくすること を念頭に設計していました。
たとえば「ユーザー情報更新通知」は、サービス側がメンテナンスなどでサーバーを停止していると、通知を受信できずにそのまま消失してしまいかねません。
これを防ぐには Amazon SQS のようなキューイングの仕組みを構築する手があります。が、それだと各サービスに「キューをポーリングする実装(Shoryuken など)」を強いることになってしまいます。負担を小さくしたいのに、これでは本末転倒ですよね。
そこで今回考えたのが、「各サービスから共通基盤に対して、heartbeat的なAPIを定期的に呼び出し続ける」という仕組みです。
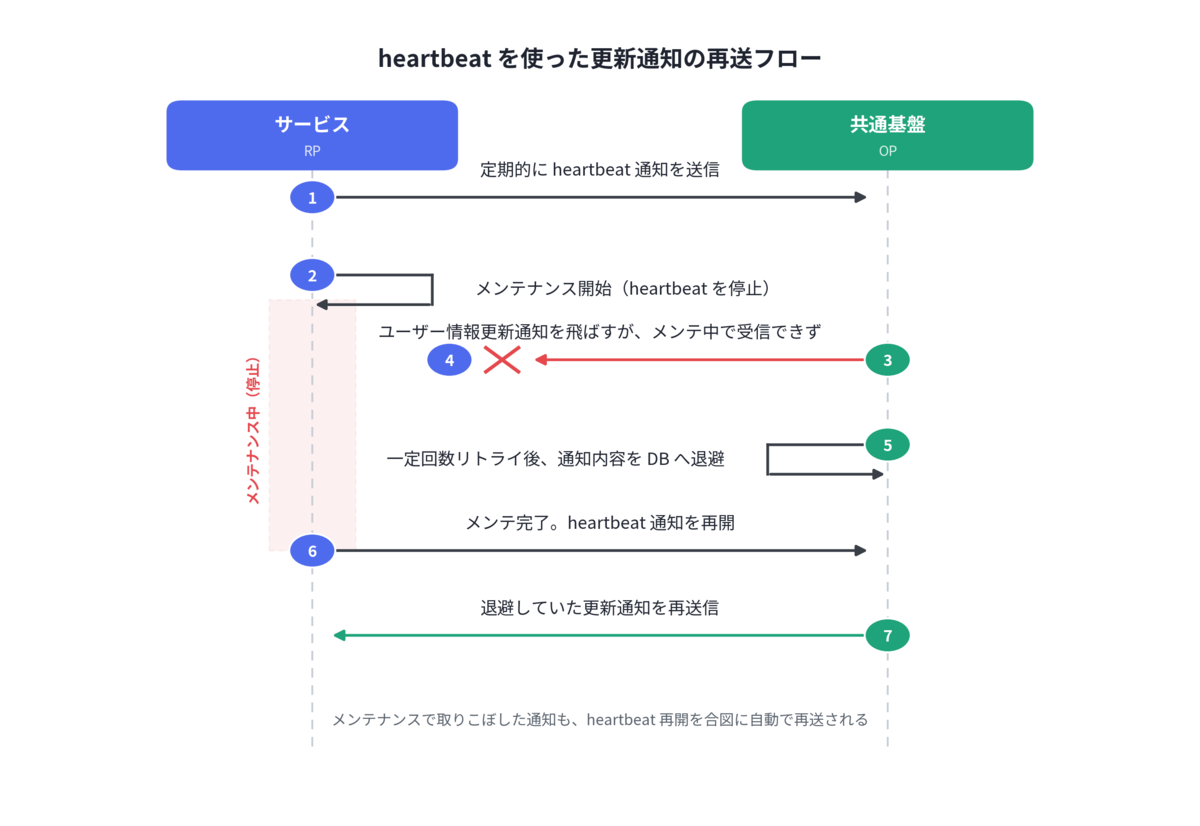
- サービスは定期的にheartbeat通知を共通基盤に送信する
- メンテナンス開始のタイミングでheartbeat通知を停止する
- 共通基盤でユーザー情報が更新され、サービスへ「ユーザー情報更新通知」を飛ばす
- サービスはサーバーメンテナンス中のため、通知を受信できない
- 共通基盤は一定回数リトライした後、通知内容を共通基盤DBに退避的に記録しておく
- サービスのメンテナンスが完了し、再びheartbeat通知を共通基盤へ送信する
- 共通基盤はheartbeat通知を受信したタイミングで、退避していた「ユーザー情報更新通知」を再送信する
「heartbeat通知を定期実行する」ことはサービス側にお願いすることになりますが、cron的な仕組みはどのサービスにも既に備わっているため、さほどの労力にはならないと判断しました。
この仕組みのおかげで、いずれかのサービスでサーバーメンテナンスが発生しても、この通知の文脈では人間が手を介すことなく、メンテナンス終了とともに自然とユーザー情報連携が再開 されるようになっています。
キューを増やすのではなく、すでにある「定期実行」という最小の前提だけで消失対策ができる。シンプルですが、我ながら気に入っている設計です。
🔐 認証連携 🔐
続いて、本丸の「認証」です。
これまでの仕組みと課題
前述の通り、MedPeerには一部Cookieを共有することで認証状態を別システムに引き継ぐ仕組みがありました。長く使われてきた仕組みではあるのですが、いくつか課題を抱えていました。
- 独自実装のためキャッチアップコストが発生する。新しく関わる人が仕組みを理解するまでに時間がかかります。
- 認証状態を再現できるようなセンシティブな値をCookieで複数サービス間に共有している。そのため、各サービスの担当者がログマスキングなどを適切に気をつけ続けなければなりませんでした。
独自実装は、書いた本人や当時のチームにとっては自然でも、サービスが増えるほど「全員が正しく気をつける」ことを要求してしまいます。これはスケールしません。
OpenID Connectへの移行
そこで今回、認証連携を 標準的な OpenID Connect に切り替えました。
- 標準規格が定められているため キャッチアップコストが低い。そしてこれは個人的に大きいと感じているのですが、AIコーディングとの相性も良い です。世に情報が溢れている標準規格は、AIにとっても扱いやすい題材ですよね。
- セキュリティ面でも、独自実装より厳格にできます。
なお、後述しますが 一部のCookie共有は残す ことになりました。
「標準規格である」という価値
「キャッチアップコストが低い」と一言で書きましたが、ここは今回の判断の肝なのでもう少し掘り下げさせてください。
元々の独自実装の認証機構では、RP側の実装を共通化するために 社内Gem が作られていました。OmniAuthのカスタムストラテジや、専用API呼び出し用のクライアントライブラリです。独自仕様で会話する以上、その手順を各サービスで再実装させるわけにはいきませんから、ライブラリにまとめて配布するのは自然な発想です。
今回も当初は「同じようにクライアントライブラリを作るか」と検討しました。が、ここで一度立ち止まりました。
OpenID Connectは標準規格です。 わざわざ自分たちで独自にライブラリを管理するのは、むしろ過剰なのではないか? と。最終的には、独自ライブラリで囲い込むのではなく、各RPがそれぞれ規格に準拠した形で実装する という方針にしました。
この判断を後押ししたのが、社内の技術スタックの広がりです。
弊社はRuby on Railsなシステムが大半ですが、最近はフロントエンド・バックエンドともにTypeScriptで構成されたシステムや、LLM活用度合いの高いプロダクトでPythonを採用するシステムも徐々に増えてきています。
こうなると、言語ごとにクライアントライブラリを自作してメンテし続ける のは、なかなかに大変です。それなら、業界標準であるOpenID Connectという「共通言語」で会話してもらう方が、長い目で見て筋が良いと考えました。
独自実装は、自分たちで自由に作れる代わりに、自分たちで一生面倒を見続ける宿命を背負います。標準規格に乗るというのは、その面倒の多くを世界中のエコシステムに肩代わりしてもらう、という選択でもあるのだと改めて感じています。
迷い
本設計・実装を進めている中で以下の黒曜さんのセッション(「ドメイン指定Cookieとサービス間共有Redisで作る認証基盤サービス Kaigi on Rails 2025より」)が目に留まりました。これはMedPeerの旧システムに近い仕組みで、Cookieでセッション情報を共有するといったものです。 正直、自社サービス内だけであればOpenID Connectは過剰であるという意見は大いに同意するものの上述の「標準規格のメリット」そして「外部への認証機構の提供の可能性」を考慮し、今回はOpenID Connect準拠の決断をしました。
主な実装内容
主な実装内容は、大きく3つです。
1. Authorization Code Flow(認可コードフロー)への準拠
基本となる認可フローは Authorization Code Flow に準拠しました。ただし、アクセストークン・リフレッシュトークンの発行は行っていません。隔離されたサーバー間通信が前提のため、認可コード/IDトークンの交換以降は、ユーザー情報を前述の「ユーザー情報取得API」でサーバー間に取りに行く構成としたためです。標準に忠実であることと、自分たちの構成で本当に必要な範囲を見極めることの、バランスを取った形です。
2. シングルログアウト(SLO)
実はOpenID Connectには、シングルログアウト(SLO)についても規格が定められています。お恥ずかしながら、私は今回まで知りませんでした。「ログインの規格」という印象が強かったのですが、ログアウトまでちゃんと面倒を見てくれるのですね。
SLOは、以下二つの組み合わせで実現されます。
- Back-Channel Logout
- 共通基盤(OP)がログアウトしたら、つながっている全サービス(RP)もログアウトする
- RP-Initiated Logout
- RPがログアウトしたら、OPもログアウトする
本件についてはこれといった工夫も特になく、それぞれの規格に準拠する形で実装しました。 SLOの規格としてもう一つ Front-Channel Logout というものがありますが、これはサービスが増えれば増えるほど安定性に欠けると判断し採用しませんでした。
3. シームレスなシングルログイン体験
一方で、こんな体験も求められました。
「MedPeerにログインしているユーザーが、初めてClinPeerにアクセスしたら、明示的なログイン操作なしでログイン状態としたい」
これは OpenID Connectに該当する規格がないため、独自実装 です。標準に乗れるところは素直に乗り、乗れないところだけ最小限で作る。今回の認証連携は、終始この方針でした。
そして、ここで先ほどの「一部Cookie共有」が登場します。logged_in = yes / no という 情報だけ を持つCookieをサービス間で共有します。
各RP(連携先サービス)へ未ログイン状態でアクセスしたタイミングでこのCookieを参照し、logged_in = yes(つまり共通基盤側ではログイン済み)の場合は即座にOpenID Connectのフローを発火させ、自動的にログイン状態とします。
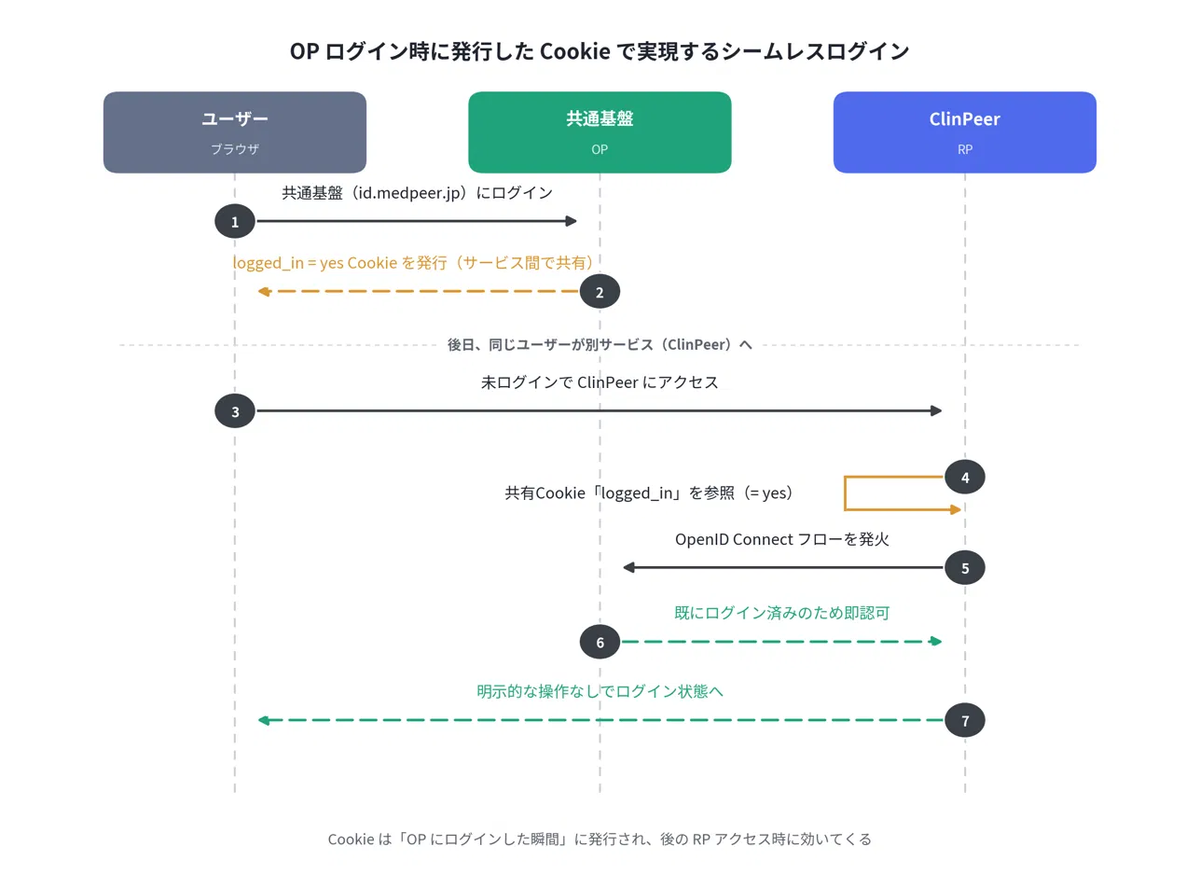
センシティブな認証情報の共有はやめつつ、yes / no という当たり障りのない一片の情報だけは共有することで、ユーザーから見たときの「気づいたらもうログインできている」というシームレスな体験は維持する。課題だったCookie共有を完全にゼロにするのではなく、残すべき最小限まで削ぎ落とした という落とし所です。
📍 現在地 — すべての医師向けサービスがつながった 📍
ここまで設計の話を続けてきましたが、現在の状況にも触れておきます。
共通基盤プロジェクトが開始しておおよそ1年が経過した頃、すべての医師向けサービス(MedPeer / ClinPeer / MedPeer Career / みんコレ!※)が共通基盤に接続し、ユーザー・認証を一元管理できる状態 となりました。
※ みんコレ! は共通基盤プロジェクトの最中に、新規で共通基盤への接続が決まったサービスです。ユーザーの移行作業などが不要だったため、驚くほどスムーズに共通基盤に接続することができました。
裏側ではこれだけ大きな切り替え作業を実施しているにもかかわらず、ダウンタイムなし・大きな障害なしで完遂 できました。これは我ながら上出来だったのではないかと、ちょっとだけ自負しています。(こういうものは、何事もなく終わったときほど語られないものですが今回は自分で言わせてください。)
そして現在は、次のステップとして「利用規約の同意状況の一元管理」や「問い合わせ対応システムの統合・刷新」を進めています。
これらはいずれも「単なるリプレイス」では終わらせず、「共通基盤として提供するべきものは何か」を一つひとつ再定義しながら設計しています。「今必要だから」という理由だけでなく、「今後サービス展開が拡大していく上で必要になるか」を意識して仕様を定義しているのです。
これは YAGNIの原則に一定反している、という自覚はあります。「必要になってから作れ」という教えは、普段の機能開発であれば私も賛成です。
ですが、他のあらゆるサービスの基礎となる共通基盤 においては、こういった先読みはむしろ必要だと考えています。土台を後から作り直すのは、その上に乗っているものすべてを揺らすことになります。原則は原則として尊重しつつ、それが効く文脈とそうでない文脈を見極める。この塩梅こそが共通基盤づくりの難しさであり、面白さなのかもしれません。
👋 まとめ 👋
長くなりましたが、メドピアの共通基盤プロジェクトについて、ユーザー情報連携と認証連携を中心にご紹介しました。
10年もののモノリスから根幹機能を切り出すのは、正直なところ気の重い作業の連続です。それでも、
- 過去の負債を引き継がない という意思を持ってデータの持ち方から見直す
- 各サービスの開発負担を小さくする ことを軸に、heartbeatのような素朴で確実な仕組みを選ぶ
- 独自実装を 標準規格(OpenID Connect) に寄せてキャッチアップコストとセキュリティリスクを下げる
といった一つひとつの判断が、これからのサービス展開を支える土台になると信じて進めています。
共通基盤プロジェクトはまだ道半ばです。今後、お問い合わせ管理やポイント管理の切り出しなど、続きをまたどこかでご紹介できればと思っています。似た課題に立ち向かっている方の参考に少しでもなれば幸いです。
是非読者になってください!
メドピアでは一緒に働く仲間を募集しています。
ご応募をお待ちしております!
■募集ポジションはこちら hrmos.co
■エンジニア紹介ページはこちら engineer.medpeer.co.jp
■メドピア公式YouTube www.youtube.com
■メドピア公式note
style.medpeer.co.jp
